MCP et stratégies agentiques
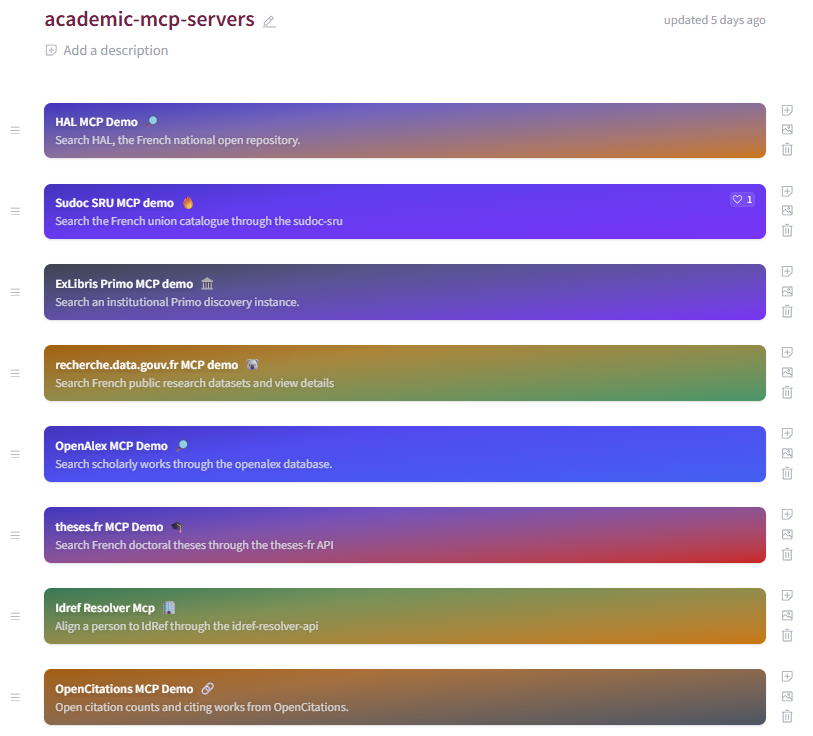
Le dépôt open source smartbiblia-solutions/agentic-stack sert de fil rouge et de terrain d’expérimentation concret des architectures décrites dans la suite du billet, en proposant des skills, des serveurs MCP, une CLI d'installation et quelques configurations d’agents appliqués aux données et aux méthodes de la documentation et de la recherche. Les MCP du dépôt sont par ailleurs déployés sur HuggingFace et regroupés dans cette collection.
Depuis OpenClaw et Claude Code, le trend autour de l’agentique ne faiblit pas, avec chaque semaine ou presque l’apparition d’un nouveau framework encore plus léger, plus portable et plus simple à installer que le précédent (OpenCode, Hermes Agent, PI, DeepSeek Harness…), traduisant un mouvement de fond et une convergence vers des environnements d’agents open source et facilement configurables au-dessus des modèles. Les harnais eux-même, la gestion de la mémoire à long terme ou encore la structuration des KB internes deviennent progressivement des objets d’étude et de recherche à part entière tant leur optimisation ou leur capacité d’adaptation en temps réel durant l’exécution de l’agent ont un impact sur les performances des conceptions agentiques. Dans le même temps, la standardisation des formats et protocoles relatifs à chaque couche de l'infrastructure se poursuit, dessinant une organisation agentique de référence de plus en plus modulaire, ouverte et interopérable. Citons par exemple (de manière non exhaustive)
- le format AGENTS.md qui documente les règles d’un projet à destination des agents ;
- le format Agent Skills qui organise la façon dont on transmet une procédure au modèle via un fichier SKILL.md ;
Rappel sur les skills
Une skill est un dossier contenant au minimum un fichier SKILL.md, composé d’un petit bloc de métadonnées et d’instructions en Markdown, auquel peuvent s’ajouter des scripts, des références, des schémas, des exemples, des modèles de documents ou d’autres ressources. Elle a pour but de formaliser et documenter une expertise, une tâche, un processus, une méthodologie, par exemple une stratégie de recherche documentaire, les critères de sélection d’un corpus, une procédure d’alignement d’autorités, une méthode de lecture critique ou les contraintes d’un plan de gestion de données. - le protocole MCP qui standardise la connexion à des outils et des ressources externes ;
- le protocole A2A (Agent2Agent) qui formalise la découverte et la communication entre agents ;
- le standard OKF (Open Knowledge Format) proposé par Google, qui organise des corpus de connaissances en fichiers Markdown enrichis de métadonnées de provenance, de confiance et de fraîcheur ;
- ou encore la dernière spécification en date Agent Plugins 1.0 qui standardise la manière dont des skills et des configurations MCP peuvent être distribuées ensemble dans un paquet réutilisable et installable (plugin), introduisant une unité de distribution commune sans supprimer l’autonomie des ressources qu’elle rassemble.
Tout ceci tend à modeler des structures d’agents composées de briques standardisées susceptibles d’être recombinées de multiples manières (le même serveur MCP pouvant être associé à différentes skills, elles-mêmes combinées entre elles, puis l’ensemble empaqueté dans un plugin utilisable par plusieurs frameworks agentiques), offrant un réel gain de redistribution puisqu’il n’est plus nécessaire de réassembler toute la mécanique à chaque installation, mais sans pour autant verrouiller chaque composant au niveau de granularité le plus fin, qui reste disponible séparément et peut continuer à circuler d’un workflow à l’autre.
Au sein de ces environnements, les MCP sont donc des composants parmi d'autres agissant au niveau de la couche d’action (les tools chargés de doter le modèle de capacités supplémentaires), laquelle n’étant elle-même qu’une des briques grâce auxquelles le harness construit et gouverne le contexte informationnel de l’agent. Un serveur MCP peut certes être utilisé isolément dans un chat, mais il prend tout son sens lorsqu’il alimente un pipeline d’agent, et fabriquer ou adapter un agent consiste précisément à emboîter ces différents composants dans un système cohérent qui exploite et encadre les capacités génératives d’un modèle.
J’ai déjà décrit dans deux précédents billets (ici et là) sur le fonctionnement des MCP comme port universel permettant à tout agent compatible de se brancher sur un service externe, et défendu l’idée que les bibliothèques devaient elles aussi s’emparer de cette nouvelle technologie de dissémination, en la considérant "juste" comme un protocole supplémentaire d’interopérabilité à destination spécifiquement des LLM qui permet de rendre leurs données atteignables depuis les environnements agentiques.
La proposition reste valide, mais ce billet vise à la préciser en resituant les MCP dans leur contexte réel d’exécution afin de rappeler qu’ils ne constituent ni l’alpha ni l’oméga des agents IA et qu’ils s’insèrent au contraire, en tant que composant de surcroît interchangeable (remplaçable par des skills par exemple), dans une architecture modulaire où chaque couche remplit une fonction particulière. Cette distinction permet ainsi d’éviter de leur faire porter des responsabilités pour lesquelles ils n’ont pas été conçus, et d’examiner ce que cette architecture considérée dans son ensemble peut changer à terme dans la conception même des services documentaires.
Quelques précisions sur les MCP
Commençons par un rappel théorique : le protocole MCP propose une architecture client/serveur standardisée dans laquelle un serveur peut exposer des tools (des fonctions exécutables), des resources (des contenus que l’application cliente peut charger), ainsi que des prompts prédéfinis proposés à l’utilisateur.
A l’usage, le terme MCP est la plupart du temps indistinctement utilisé pour désigner tout autant le protocole (la convention d’interaction qui spécifie le transport de data doublé d'une capacité de description et de découverte) que son implémentation technique sous la forme d’un serveur qui expose des capacités d’action dans un contrat documenté.
Du point de vue du protocole, à l’instar d’une API Rest ou d’un endpoint SPARQL, MCP est agnostique aux données et ne transforme pas ce qu’il transporte. Bien souvent d'ailleurs, un serveur ne fait qu’encapsuler un endpoint préexistant en lui ajoutant une interface adaptée aux applications agentiques, dans laquelle il annonce des opérations et leurs schémas afin qu’un client et son modèle puissent les découvrir et les appeler. En tant que protocole, il ne vient donc corriger aucune modélisation incohérente, ni métadonnées lacunaires, ni une API mal conçue.
Au niveau de l’implémentation en revanche, rien n’oblige le serveur à n’être qu’un simple point d’entrée reproxifiant tels quels une API Rest, un service SRU, des manifestes IIIF ou autres. En tant que code arbitraire placé entre le modèle et un ou plusieurs backends, il peut tout à fait intégrer une couche métier de traitement, transformation, consolidation, alignement, normalisation qui s’interpose entre la données brute et l’agent, accompagné de resources expliquant le schéma restitué ou de prompts facilitant certains parcours utilisateurs.
Au vu de la souplesse du protocole, et du point de vue d’une institution souhaitant exposer ses données par MCP, la tentation peut alors être grande d’utiliser les primitives de documentation du serveur pour y implémenter des consignes, des règles ou des conseils d’usage, en voyant le MCP moins comme un middleware de redistribution des données vers un LLM que comme une vraie couche de documentation ou de modélisation permettant de déclarer ce que serait leur « bon usage », d’orienter voire d’encadrer l’utilisateur ou même de définir une persona de bibliothécaire.
Plusieurs limites à cette "surchage" :
- si l’exposition des outils est reconnue par tous les clients MCP, la prise en charge des ressources et des prompts reste plus inégale et certains clients les ignorent ou ne les chargent pas dans le contexte de l’agent.
- Publier un MCP, même "officiel" et parfaitement conçu, n’en fait ni un passage obligé ni un monopole d’accès pour les modèles d’IA, et cela n’empêche en rien d’appeler par ailleurs directement l’API sous-jacente, d’exploiter un dump ou de scraper des pages publiques. Mieux même, et à la différence des API dont la conception relèvent généralement du producteur ou de l’agrégateur de la donnée qui en contrôle ainsi unilatéralement le contenu exposé et l'infrastructure d’exposition, tout usager (citoyen, chercheur, service ou bibliothécaire) peut développer son propre connecteur MCP sur des données accessibles, soit pour l’exécuter localement en
stdiosoit pour l’héberger et le rendre public derrière un endpoint HTTP streamable. Bien sûr un serveur officiel conserve une valeur particulière d’autorité, de stabilité et de connaissance du périmètre, mais cette autorité ne peut être confondue avec une exclusivité technique. - Enfin, plus qu'une limitation technique, le dernier point tient à l'architecture même des agents IA : un serveur MCP est calibré pour décrire ce que fait et ce que retourne chaque opération (fonction), mais la manière d’enchaîner ces opérations dans un flux de travail, les méthodes d’appel, les séquences d’exécution, et l’interprétation des réponses appartiennent à la couche d’orchestration définie par le harnais et exécuté par le modèle dans le framework. Dans un contexte agentique, les ressources sont mobilisées dans des processus dont une partie de l’enchaînement est décidée dynamiquement au niveau du harness, et la couche pertinente pour implémenter une logique métier réside donc précisément dans cette couche d’orchestration plutôt qu’au niveau du serveur MCP, chargé avant tout de résoudre un problème d’interopérabilité technique. Dit plus simplement, enrichir un MCP de contexte métier ne le transformera pas pour autant en stratégie agentique complète.
Construire des stratégies agentiques
En réalité, la logique agentique vient bousculer la manière dont les bibliothèques ont accompagné les précédentes vagues d’interopérabilité en structurant leurs données, en adoptant des formats communs, en développant des protocoles d’échange et en construisant des services et des interfaces destinés à les exploiter.
Au fil de la pénétration des outils agentiques via les frameworks et chatbots IA, les usagers arrivent en effet de plus en plus équipés de leurs propres environnements d'agents capables de choisir des outils, combiner plusieurs sources et exécuter des workflows. Dans un tel contexte, et au regard des limites posées plus haut, rendre ses données accessibles au moyen d’un serveur MCP ne suffit probablement pas lorsqu’un chercheur souhaite utiliser son agent habituel pour conduire une recherche bibliographique, comparer des publications, explorer des jeux de données ou préparer un état de l’art.
On boucle ici sur l’architecture composable évoquée en introduction car, au-delà du simple endpoint vers les sources qu’un MCP va fournir à l’agent, l’enjeu consiste en fait à transposer autant les ressources que les méthodes documentaires, en les transformant en capacités composables assez intégrées pour être facilement installées mais assez modulaires pour rester adaptables et partageables.
Afin d'illustrer ce que signifie réellement architecturer un agent (décider de l’ordre des opérations, des bifurcations, des contrôles, des artefacts conservés ...), voici trois exemples simplifiés d'assemblages documentaires qui exploitent les éléments du dépôt smartbiblia-solutions/agentic-stack, configurés et orchestrés au niveau de l'agent (notamment son fichier AGENTS.md).
Cataloguer une thèse à partir de sa page de titre
Le premier exemple est celui d'un agent catalogueur de thèse (démonstrateur simplifié) qui produit une proposition de notice Unimarc avec les autorités personnes alignées sur Idref à partir image de page de titre.
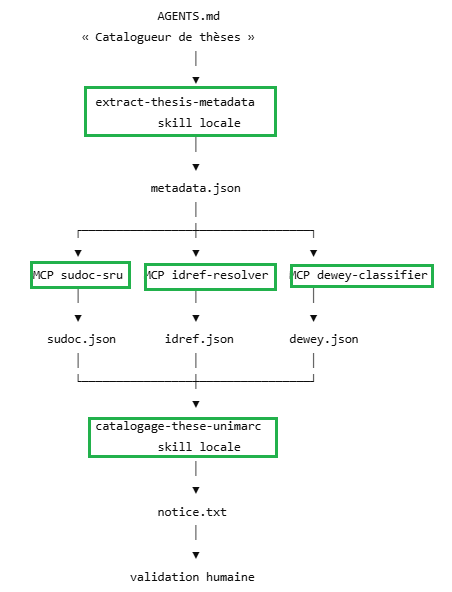
L’intérêt de cet assemblage n’est pas seulement de montrer qu’un agent peut appeler successivement plusieurs outils mais d'illustrer de quelle manière une stratégie agentique consiste à répartir la logique des actions entre les composants (définition des métadonnées à extraire dans la première skill -> accès aux services externes spécialisées via des serveurs MCP -> règles Unimarc dans la dernière skill) tout en orchestrant et pilotant le workflow global depuis le fichier AGENTS.md (organisation du passage d’une étape à l’autre, gestion des fichiers intermédiaires, conditions d’arrêt si si une notice correspondant clairement au document existe déjà dans le Sudoc, règles de validation si un alignement IdRef est insuffisamment fiable, etc...)
Construire une revue de littérature traçable
Ici, le point d'attention réside moins dans l'enchaînement des opérations que dans la coordination entre plusieurs sources dans un même espace documentaire avec conservation de la provenance et des résultats intermédiaires, l’agent devant créer un répertoire de recherche persistant, distribuer les requêtes entre plusieurs sources, fusionner et dédupliquer les résultats, conserver un journal de sélection puis valider les sorties structurées avant de passer à l’étape suivante.
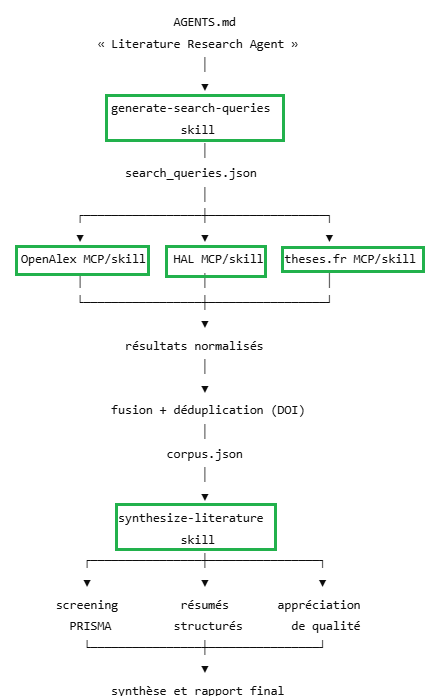
A noter que la composition d'un agent n'est pas figée en fonction de la méthode documentaire globale, chaque étape, chaque composant et la manière dont ils sont coordonnés relevant de choix contextuels dépendants de l'expérience et l'expertise métier (pour cette source il vaut mieux une skill avec une CLI qu'un MCP) ou de l'adaptabilité prévue à plusieurs types de frameworks et plusieurs catégories de LLMs (pour un agent exécuté dans PI connecté à un SLM local mieux vaut ne pas construire des pipelines avec des phasages trop complexes)...
Enfin, cet exemple permet aussi d'illustrer que le serveur MCP OpenAlex (par exemple) n’est ici qu’un composant de recherche parmi d’autres, qui ne détermine pas à lui seul le service auquel il participe. Si une bibliothèque avait conçu et publié un tel agent, l'étudiant ou le chercheur qui utilise Claude pour conduire sa recherche bibliographique pourrait ainsi l'installer comme un package, ou pourrait tout autant n’en prélever que le MCP OpenAlex pour le réutiliser dans un autre agent de cartographie scientifique, de suivi de la production d’un laboratoire ou d’analyse des dynamiques thématiques, avec une orchestration, des critères d’évaluation et des formats de sortie complètement différents.
Accompagner la rédaction d’un plan de gestion de données
Ce troisième exemple d'assemblage, plus léger et pour l’instant très prospectif, concerne l’accompagnement à la rédaction d’un plan de gestion de données. Multiplier les outils est ici inutile car la valeur du système réside plutôt dans sa capacité à recueillir et vérifier les informations nécessaires (via la skill write-data-management-plan qui porte la méthodologie de rédaction du PGD) et ne mobilise la source externe recherche.data.gouv.fr que lorsque le workflow nécessite d’examiner une collection, ses blocs de métadonnées, ses fichiers ou ses modalités d’accès
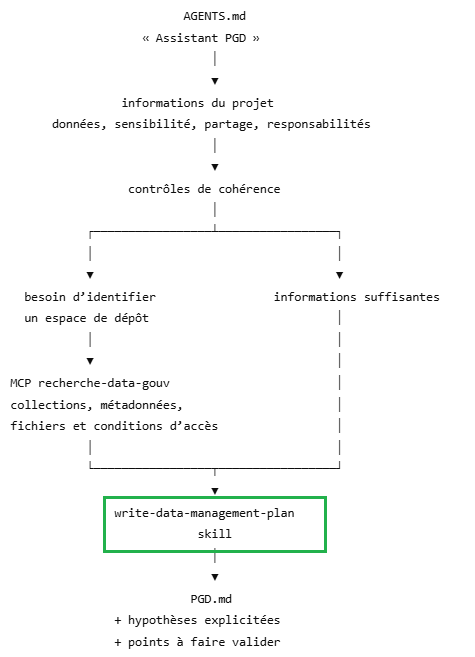
Cet assemblage volontairement réduit montre qu’une architecture agentique ne se nécessite pas forcément plusieurs composants connectés et que, dans certains cas, une skill Markdown et quelques règles d’orchestration suffisent pour conditionner l'appel d'un outil ou prévoir les situations dans lesquelles l’agent doit suspendre son exécution pour demander une décision humaine.
A travers ces quelques exemples basiques, on voit donc comment, pour une bibliothèque qui souhaite exposer pour des usages agentiques ses collections et ses métadonnées, le périmètre de mise en oeuvre peut s'élargir, depuis le protocole MCP qui à première vue s’inscrit "juste" dans une histoire familière d’endpoints interopérables, jusqu'à la logique agentique complète qui implique d'également encoder et transposer l'expertise documentaire accompagnant les données dans un assemblage portable de méthodes, de connecteurs et de modèles de résultats.
Sur le plan de l'intermédiation entre les usagers et les métadonnées, on peut noter que ce déplacement introduit également une forme d’autonomisation de l’usager dans la mesure où la structure modulaire des agents permet à l’utilisateur de recomposer lui-même son environnement, de choisir ses outils, de croiser des sources et personnaliser son format de restitution, en s'abstrayant potentiellement des interfaces de recherche classiques conçues, organisées et dans une certaine mesure contrôlées par les professionnels qui en déterminaient les champs, les filtres et les parcours.
Devenir architecte (et catalogueur ?) de composants agentiques
Même si elle peut paraître un peu prospective, la suite procède assez directement de ce qui précède puisqu'en effet, si les usagers disposent progressivement d’environnements dans lesquels ils peuvent installer un connecteur, charger une skill ou ajouter un plugin, le rôle de la bibliothèque tend à ne plus se limiter seulement à mettre ses données à disposition ni même à développer sa propre interface conversationnelle, il peut (il doit) aussi consister à intervenir dans la composition des environnements agentiques, d’une part en contribuant à l’interopérabilité des données, méthodes et services documentaires, et d’autre part en renforçant sa capacité à construire autour du modèle un environnement documentaire fiable et proportionné à la tâche.
Partons du principe que, même concernant l'IA, l’autonomie technique des usagers ne supprime pas le besoin de médiation documentaire, les bibliothèques pourraient ainsi se positionner sur au moins trois dimensions complémentaires :
- Comme fournisseuses de données rendues atteignables par les agents (développement de MCP et de skills )
- Comme architectes de services documentaires distribués sous forme de composants à la fois modulables et intégrés (plugins, agents), ce qui suppose une extension du domaine des compétences visant à comprendre pleinement les architectures agentiques, à savoir distinguer ce qui relève du modèle, du harnais, des instructions, de la mémoire, des skills, des outils natifs, des serveurs MCP ou des plugins, ou encore à être en capacité de faire les bons choix d’architecture comme choisir entre MCP ou skill pour accéder à des données externes (selon les contextes une skill accompagnée d’une CLI peut être préférée à un serveur MCP) ou arbitrer le bon niveau de granularité de l'enveloppe de distribution (la package et/ou les composants).
- Comme tiers de référence capables de signaler, d’évaluer et de recommander des composants : en extrapolant, on entrevoit les nouveaux types d'accompagnement que les bibliothèques pourraient être amenées à prendre en charge, qui ne porterait plus uniquement sur la formulation d’une requête dans une interface, l'élaboration d'une stratégie de recherche ou la structuration d'un corpus mais sur la conception du système qui produira la réponse, sur l’aide à la modélisation de l'agent, au choix du plugin, à la sélection du MCP connecté sur la bonne source de donnée. Assurer ce type de service s’appuie en particulier sur une activité de veille et de curation (repérer des skills & MCP & plugins dans les hubs existants, les évaluer avec plusieurs modèles et plusieurs clients) et sur un travail d’architecture documentaire dans lequel la connaissance des données et des méthodes compte autant que la maîtrise du framework (quelles sources interroger, quelles skills mobiliser, dans quel ordre exécuter les opérations, quels artefacts conserver, quels résultats considérer comme acceptables... ?).
En complément de ces considérations, la multiplication des registres de MCP, des plateformes de skills et des marketplaces de plugins a au moins deux conséquences.
- une première assez immédiate qui, comme évoqué ci-dessus, place la capacité à repérer, qualifier, tester et évaluer les ressources disponibles en tête des compétences à acquérir à mesure que l’offre s’étoffe
- cette géographie des registres donne, même de manière imparfaite, une indication du niveau de pénétration et d’appropriation de l’IA agentique dans les différentes communautés académiques, dessinant en creux les champs disciplinaires dans lesquels les spécialistes du domaine ont déjà largement investi le terrain, et à contrario ceux dans lesquels un positionnement en appui sur ces dimensions peut apporter une réelle plus-value. Il suffit par exemple de parcourir le hub lawve.ai pour constater que les professionnels du droit et les acteurs de la LegalTech n’ont pas attendu les bibliothèques pour produire, assembler et diffuser des skills et des MCP adaptés à leurs propres pratiques.
J'ai déjà exprimé cette idée par ailleurs, mais cette profusion plaide aussi, pourquoi pas, pour la mise en œuvre d’un catalogue collaboratif de référence consacré aux composants agentiques orienté vers la documentation et la recherche qui décrirait ces artefacts particuliers (qui embarquent simultanément du code, des instructions une capacité d’action) selon un cadre normalisé et en établissant de plus des liens qualifiés entre les ressources (telle skill utilise tel serveur MCP, entre dans la composition de tel plugin, peut être remplacée par telle autre ou a été testée avec tel modèle et tel harness...). Autrement dit, appliquer à l’écosystème agentique une véritable logique de catalogage avec une description normalisée qui permettrait de rendre ces composants découvrables dans un catalogue de confiance.